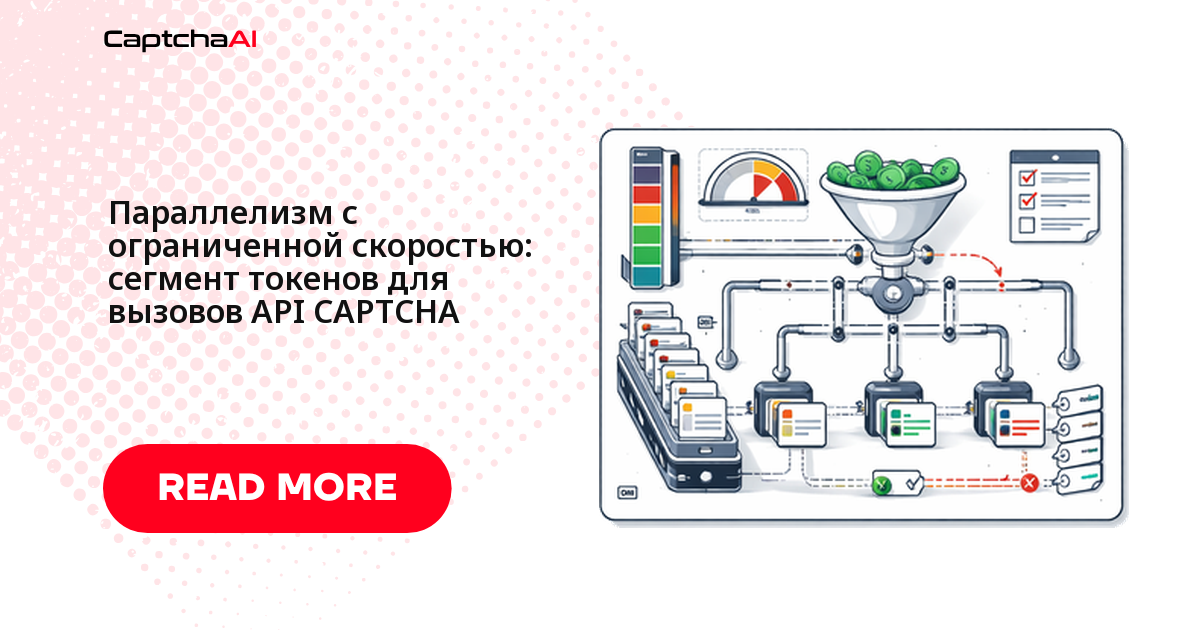
Короткий ответ: поставьте корзину токенов (token bucket) перед вызовом in.php, задайте ей устойчивую частоту и запас на всплеск — и пул воркеров перестанет упираться в ERROR_TOO_MUCH_REQUESTS. Сам пул при этом можно не трогать: ограничивается не число потоков, а темп отправок.
Разницу часто путают. Тариф CaptchaAI считает потоки — сколько задач CAPTCHA одновременно в работе: BASIC ($15/мес, 5 потоков), ADVANCE ($90/мес, 50 потоков). Частота HTTP-запросов к in.php — отдельная величина, и ломается обычно она, когда ThreadPoolExecutor на тридцать воркеров просыпается разом.
Дальше — устройство алгоритма, реализации на Python и JavaScript, подбор параметров и разбор сбоев.
Как устроен алгоритм token bucket
[Bucket] capacity=20, refill=10/sec

Time 0:  ████████████████████  20 tokens available
         → 15 requests consume 15 tokens
Time 0:  █████                 5 tokens remain

Time 1s: ███████████████       15 tokens (5 + 10 refilled)
         → 15 requests consume 15 tokens
Time 1s: (empty)               0 tokens

Time 2s: ██████████            10 tokens (0 + 10 refilled)
         → Request waits if bucket is empty
В корзине лежат токены, каждый запрос забирает один. Токены капают обратно с постоянной скоростью и сверх потолка не накапливаются. Отсюда два параметра:
- Ёмкость (capacity) — потолок корзины, то есть максимальный всплеск. Если корзина полна, 20 отправок уйдут мгновенно, одна за другой.
- Частота пополнения (refill rate) — устойчивый темп в запросах в секунду. Это то, что вы держите в среднем на длинной дистанции.
Третье свойство — поведение при пустой корзине: запрос ждёт, а не отклоняется. Для решения CAPTCHA это правильный выбор — задача не теряется, просто стартует на несколько сотен миллисекунд позже.
Реализация на Python: потокобезопасная корзина
Класс TokenBucket с блокировкой
import time
import threading


class TokenBucket:
    def __init__(self, capacity, refill_rate):
        """
        Args:
            capacity: Maximum tokens (burst size)
            refill_rate: Tokens added per second
        """
        self.capacity = capacity
        self.refill_rate = refill_rate
        self.tokens = capacity
        self.last_refill = time.monotonic()
        self.lock = threading.Lock()

    def acquire(self, timeout=None):
        """Block until a token is available."""
        deadline = time.monotonic() + timeout if timeout else float("inf")

        while True:
            with self.lock:
                self._refill()
                if self.tokens >= 1:
                    self.tokens -= 1
                    return True

            # Check timeout
            if time.monotonic() >= deadline:
                return False

            # Wait before retrying (avoid busy loop)
            time.sleep(min(1.0 / self.refill_rate, 0.1))

    def _refill(self):
        now = time.monotonic()
        elapsed = now - self.last_refill
        new_tokens = elapsed * self.refill_rate
        self.tokens = min(self.capacity, self.tokens + new_tokens)
        self.last_refill = now
Две детали, которые часто упускают в самописных лимитерах: пополнение считается по time.monotonic(), а не по time.time() — иначе синхронизация по NTP собьёт расчёт; пауза в цикле ограничена сверху 0,1 с, чтобы ожидание не стало busy loop. Параметр timeout возвращает False, если токен так и не появился, — удобно, когда у задачи есть свой дедлайн.
Подключение корзины к отправке задачи в in.php
import os
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

API_KEY = os.environ["CAPTCHAAI_API_KEY"]

# Allow 10 submissions/sec with burst of 20
rate_limiter = TokenBucket(capacity=20, refill_rate=10)


def solve_captcha_rate_limited(sitekey, pageurl):
    """Solve with rate limiting on submission."""
    # Wait for token before submitting
    rate_limiter.acquire()

    resp = requests.post("https://ocr.captchaai.com/in.php", data={
        "key": API_KEY,
        "method": "userrecaptcha",
        "googlekey": sitekey,
        "pageurl": pageurl,
        "json": 1
    })
    data = resp.json()

    if data.get("status") != 1:
        raise RuntimeError(data.get("request"))

    captcha_id = data["request"]

    # Polling doesn't need rate limiting (separate concern)
    for _ in range(60):
        time.sleep(5)
        result = requests.get("https://ocr.captchaai.com/res.php", params={
            "key": API_KEY, "action": "get", "id": captcha_id, "json": 1
        }).json()

        if result.get("status") == 1:
            return result["request"]
        if result.get("request") != "CAPCHA_NOT_READY":
            raise RuntimeError(result.get("request"))

    raise TimeoutError("Solve timeout")


# Run 100 tasks through rate limiter
tasks = [
    {"sitekey": "6Le-wvkSAAAAAPBMRTvw0Q4Muexq9bi0DJwx_mJ-",
     "pageurl": f"https://example.com/p/{i}"}
    for i in range(100)
]

with ThreadPoolExecutor(max_workers=30) as executor:
    futures = {
        executor.submit(
            solve_captcha_rate_limited, t["sitekey"], t["pageurl"]
        ): t for t in tasks
    }

    for future in as_completed(futures):
        task = futures[future]
        try:
            solution = future.result()
            print(f"[OK] {task['pageurl']}")
        except Exception as e:
            print(f"[ERR] {task['pageurl']}: {e}")
Важен порядок: acquire() вызывается до requests.post, то есть ограничивается отправка. Цикл опроса res.php через токен не проходит — он уже саморегулируется паузой time.sleep(5), и лишние токены на него тратить незачем.
ThreadPoolExecutor(max_workers=30) и корзина работают на разных уровнях: пул задаёт, сколько задач висит одновременно (это потоки тарифа), корзина — с какой скоростью они стартуют.
Реализация на JavaScript: асинхронный вариант
Корзина токенов на промисах
class TokenBucket {
  constructor(capacity, refillRate) {
    this.capacity = capacity;
    this.refillRate = refillRate; // tokens per second
    this.tokens = capacity;
    this.lastRefill = Date.now();
    this.waitQueue = [];
  }

  _refill() {
    const now = Date.now();
    const elapsed = (now - this.lastRefill) / 1000;
    this.tokens = Math.min(this.capacity, this.tokens + elapsed * this.refillRate);
    this.lastRefill = now;
  }

  async acquire() {
    this._refill();

    if (this.tokens >= 1) {
      this.tokens -= 1;
      return;
    }

    // Wait until a token is available
    const waitTime = ((1 - this.tokens) / this.refillRate) * 1000;
    await new Promise((resolve) => setTimeout(resolve, waitTime));

    this._refill();
    this.tokens -= 1;
  }
}
В Node.js блокировать нечего: событийный цикл однопоточный, поэтому вместо мьютекса используется await на таймере — метод считает, сколько миллисекунд ждать до следующего токена, и засыпает ровно на это время.
Ограничение у этой версии известное: несколько десятков промисов могут проснуться почти синхронно и слегка превысить заданную частоту. Нужна жёсткая граница — добавьте очередь ожидания (поле waitQueue оставлено под это).
Пакетная отправка ста задач
const axios = require("axios");

const API_KEY = process.env.CAPTCHAAI_API_KEY;
const rateLimiter = new TokenBucket(20, 10); // 20 burst, 10/sec sustained

function sleep(ms) {
  return new Promise((resolve) => setTimeout(resolve, ms));
}

async function solveCaptchaLimited(sitekey, pageurl) {
  // Wait for rate limit token
  await rateLimiter.acquire();

  const submitResp = await axios.post(
    "https://ocr.captchaai.com/in.php",
    null,
    {
      params: {
        key: API_KEY,
        method: "userrecaptcha",
        googlekey: sitekey,
        pageurl: pageurl,
        json: 1,
      },
    }
  );

  if (submitResp.data.status !== 1) {
    throw new Error(submitResp.data.request);
  }

  const captchaId = submitResp.data.request;

  for (let i = 0; i < 60; i++) {
    await sleep(5000);
    const result = await axios.get("https://ocr.captchaai.com/res.php", {
      params: { key: API_KEY, action: "get", id: captchaId, json: 1 },
    });

    if (result.data.status === 1) return result.data.request;
    if (result.data.request !== "CAPCHA_NOT_READY") {
      throw new Error(result.data.request);
    }
  }

  throw new Error("TIMEOUT");
}

// Solve 100 tasks — rate limiter ensures max 10 submissions/sec
async function batchSolve(tasks) {
  const results = await Promise.allSettled(
    tasks.map((t) => solveCaptchaLimited(t.sitekey, t.pageurl))
  );

  const solved = results.filter((r) => r.status === "fulfilled").length;
  const failed = results.filter((r) => r.status === "rejected").length;
  console.log(`Solved: ${solved}, Failed: ${failed}`);
}
Как подобрать ёмкость и частоту пополнения
Начинать стоит снизу. Значения ниже — отправные точки: реальный потолок зависит от тарифа и от того, сколько процессов делят один API-ключ.
| Профиль нагрузки | Ёмкость (всплеск) | Частота пополнения (устойчивая) |
|---|---|---|
| Лёгкий парсинг | 5 | 2/сек |
| Обычная автоматизация | 20 | 10/сек |
| Высоконагруженный пайплайн | 50 | 30/сек |
| Максимальная пропускная способность | 100 | 50/сек |
Три практических правила:
- Ёмкость ≈ удвоенная частота пополнения. Так корзина переваривает двухсекундный всплеск целиком — типичный случай, когда парсер разом наткнулся на пачку страниц с проверкой.
- Повышайте частоту постепенно, наблюдая за долей ошибок. Прыжок с 10/сек сразу на 50/сек не даст вам понять, где именно проходит граница.
- Ограничивайте только отправки. Опрос
res.phpлёгкий и уже растянут паузами; лишнее ограничение на нём только увеличит время решения.
Пример: агентство на 12 клиентских проектов
Команда в Алматы или Минске держит 12 клиентских парсинг-проектов на одном сервере: тариф ADVANCE ($90/мес, 50 потоков), у каждого проекта свой шедулер, ключ API один на всех. Ночью крон-задачи стартуют по круглому часу — отправки складываются в один пик.
Тариф поднимать незачем. Достаточно вынести корзину на уровень шлюза: один общий лимитер 20/сек с ёмкостью 40 вместо двенадцати независимых. Потоков это не касается, но пик сглаживается и ночные ERROR_TOO_MUCH_REQUESTS уходят.
Когда процессы разнесены по машинам, in-memory корзина перестаёт работать: каждый экземпляр считает свои токены, а API видит сумму. Тогда tokens и last_refill переезжают в общий ключ Redis.
Token bucket, leaky bucket и оконные счётчики: что выбрать
| Алгоритм | Поведение | Когда уместен |
|---|---|---|
| Token bucket | Плавная средняя частота с допуском на всплеск | Отправки задач в API CAPTCHA |
| Leaky bucket | Фиксированная скорость на выходе, всплески срезаются | Жёсткие требования к равномерности |
| Фиксированное окно | Счётчик за интервал, всплески на стыке окон | Простые квоты и счётчики |
| Скользящее окно | Счётчик за скользящий период | Точное соблюдение квоты |
Token bucket выигрывает по одной причине: нагрузка на решение CAPTCHA неравномерна. Парсер то не встречает проверок вовсе, то натыкается на двадцать подряд. Leaky bucket растянет их в очередь и добавит лишнюю задержку, фиксированное окно пропустит двойной всплеск на стыке интервалов. Корзина сочетает оба свойства: держит частоту и переваривает всплеск.
Что делать, если ошибки не ушли
| Симптом | Причина | Что сделать |
|---|---|---|
ERROR_TOO_MUCH_REQUESTS при работающем лимитере |
Частота выставлена выше, чем принимает API | Снизьте refill_rate и проверьте, не делят ли ключ несколько процессов |
| Отправки стали заметно медленнее | Токены исчерпаны, задачи ждут пополнения | Увеличьте ёмкость — всплеск не помещается в корзину |
| Память процесса растёт | Копится очередь ожидающих запросов | Ограничьте длину очереди и отклоняйте лишнее с понятной ошибкой |
| Лимит не соблюдается при нескольких процессах | Корзина живёт в памяти одного процесса | Вынесите состояние в Redis и обновляйте его атомарно |
| Частота «плавает» после долгого простоя | Часы сдвинулись между вызовами | Считайте пополнение по монотонным часам, а не по системному времени |
Логируйте не только ошибки, но и время ожидания токена. Если среднее ожидание стабильно растёт, входящий поток задач превышает вашу устойчивую частоту — настройкой корзины это не лечится.
FAQ
Ограничивать только отправки или ещё и опрос res.php?
Только отправки. Запросы к res.php лёгкие и уже разнесены паузой в 5 секунд. Пропуская их через ту же корзину, вы отнимете токены у новых задач и увеличите время решения, ничего не выиграв.
Чем ограничение частоты отличается от числа потоков в тарифе?
Это разные величины. Потоки — сколько задач CAPTCHA одновременно в обработке; их число задаёт тариф (BASIC $15/мес — 5 потоков, ADVANCE $90/мес — 50). Частота — сколько HTTP-вызовов в секунду уходит к in.php. Упереться в лимит частоты, не выбрав и половины потоков, — обычное дело.
Нужна ли отдельная корзина под каждый тип CAPTCHA?
Если типы конкурируют за пропускную способность — да: отдельные корзины для reCAPTCHA v2 и Cloudflare Turnstile не дадут большому потоку одного типа задавить другой. При сопоставимых объёмах хватит одной общей — её проще сопровождать.
Как ограничить частоту, когда воркеры разнесены по нескольким серверам?
Перенесите состояние в общее хранилище, обычно Redis: tokens и last_refill в одном ключе, пересчёт атомарный (Lua-скрипт или WATCH/MULTI). Иначе два воркера прочитают одно и то же число токенов и оба его потратят. Логика не меняется — меняется место хранения.
Что выбрать вместо ожидания — отклонять запросы?
Для парсинга и QA-прогонов ожидание почти всегда лучше: задача не теряется. Отклонение уместно там, где у вызывающей стороны есть альтернатива — например, в интерактивном сервисе. Ставьте на acquire() разумный timeout и обрабатывайте отказ явно.