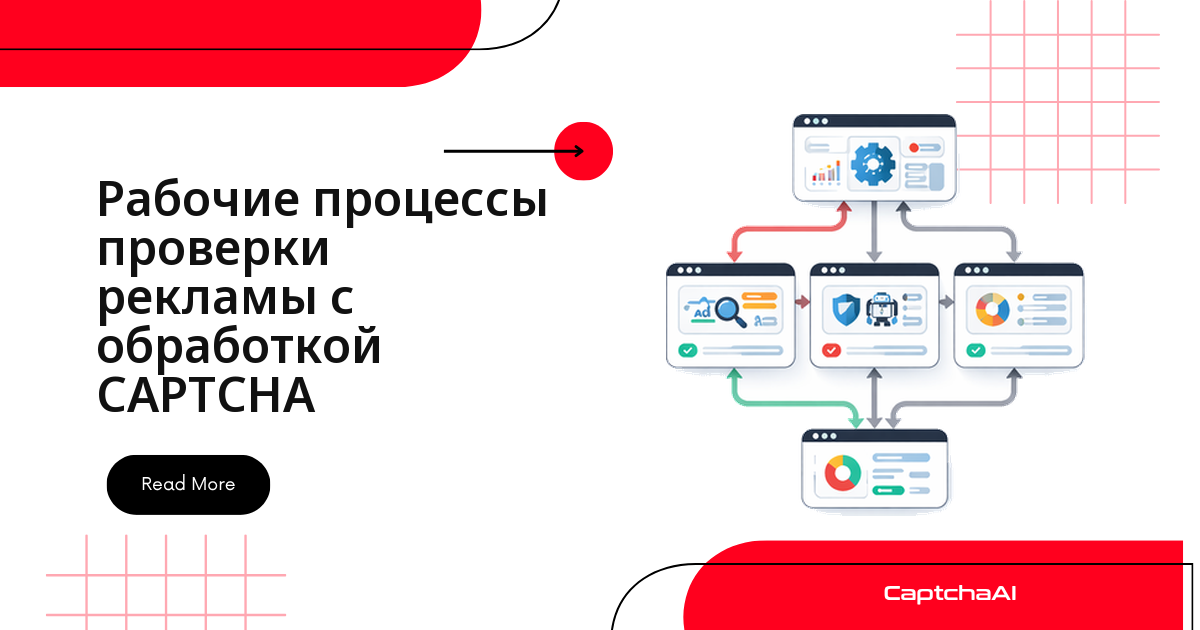
Рекламный аудит ломается не из-за медленного скрипта, а из-за CAPTCHA, которая всплывает на третьей-четвёртой странице издателя подряд. Чтобы проверить размещение, безопасность бренда и гео-таргетинг на тысячах публикаций, нужен не просто HTTP-клиент, а конвейер, умеющий решать reCAPTCHA и Cloudflare Turnstile на лету — иначе в отчёте вместо цифр появляются тайм-ауты и пустые страницы. CaptchaAI встраивается в этот конвейер как обычный API-шаг: страница отдала data-sitekey — запрос ушёл в /in.php — токен пришёл из /res.php — проверка продолжилась дальше по списку.
Где в проверке рекламы возникает CAPTCHA
Рекламные аудиторы обычно сверяют пять параметров, и защита издателя мешает почти каждому по своей причине:
| Проверка | Что оценивается | Почему включается CAPTCHA |
|---|---|---|
| Размещение рекламы | Показано ли объявление в первом экране? | Автоматические визиты страницы похожи на бота |
| Безопасность бренда | Реклама не соседствует с токсичным контентом | Массовая проверка URL напоминает парсинг |
| Видимость объявления | Реклама была реально видна пользователю? | Cloudflare помечает headless-браузеры |
| Гео-таргетинг | Нужное объявление в нужном регионе | Прокси-трафик провоцирует CAPTCHA |
| Мониторинг конкурентов | Какую рекламу показывают конкуренты | Много запросов подряд к одному домену |
Закономерность простая: чем выше частота запросов к одному издателю, тем быстрее его защита переключается в режим проверки — конкретно reCAPTCHA v2 или Cloudflare Turnstile, в зависимости от стека издателя.
Скрипт на Python: проверка страниц и решение CAPTCHA
Рабочий пример ниже перебирает список издателей, при появлении reCAPTCHA v2 решает её через CaptchaAI и параллельно ищет рекламные теги (Google Ad Manager, DoubleClick, Amazon Ads, Criteo) и ключевые слова, которые нарушают безопасность бренда:
import requests
import time
import re
import json
import os
from datetime import datetime

API_KEY = os.environ["CAPTCHAAI_API_KEY"]


def solve_captcha(method, params):
    params["key"] = API_KEY
    params["method"] = method

    resp = requests.get("https://ocr.captchaai.com/in.php", params=params)
    if not resp.text.startswith("OK|"):
        raise Exception(resp.text)

    task_id = resp.text.split("|")[1]
    for _ in range(60):
        time.sleep(5)
        result = requests.get("https://ocr.captchaai.com/res.php", params={
            "key": API_KEY, "action": "get", "id": task_id,
        })
        if result.text == "CAPCHA_NOT_READY":
            continue
        if result.text.startswith("OK|"):
            return result.text.split("|", 1)[1]
        raise Exception(result.text)
    raise TimeoutError()


def verify_ad_placement(url, session):
    """Verify ad placement on a publisher page."""
    resp = session.get(url)

    # Solve CAPTCHA if present
    match = re.search(r'data-sitekey=["\']([A-Za-z0-9_-]+)["\']', resp.text)
    if match:
        token = solve_captcha("userrecaptcha", {
            "googlekey": match.group(1),
            "pageurl": url,
        })
        resp = session.post(url, data={"g-recaptcha-response": token})

    html = resp.text

    # Check for ad elements
    result = {
        "url": url,
        "timestamp": datetime.utcnow().isoformat(),
        "ads_found": [],
        "brand_safety": True,
        "captcha_solved": match is not None,
    }

    # Detect ad tags
    ad_patterns = [
        (r'googletag\.pubads', "Google Ad Manager"),
        (r'doubleclick\.net', "DFP/DoubleClick"),
        (r'ad\.doubleclick', "DoubleClick"),
        (r'amazon-adsystem', "Amazon Ads"),
        (r'criteo\.com/.*\.js', "Criteo"),
    ]

    for pattern, name in ad_patterns:
        if re.search(pattern, html):
            result["ads_found"].append(name)

    # Brand safety check — flag problematic content
    safety_keywords = [
        "violence", "hate speech", "explicit",
        "gambling", "illegal",
    ]
    page_text = re.sub(r'<[^>]+>', '', html).lower()
    for keyword in safety_keywords:
        if keyword in page_text:
            result["brand_safety"] = False
            break

    return result


def run_verification(urls, output_file="verification_report.json"):
    """Run ad verification across multiple publisher URLs."""
    session = requests.Session()
    session.headers["User-Agent"] = (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 Chrome/120.0.0.0"
    )

    results = []
    for i, url in enumerate(urls):
        try:
            result = verify_ad_placement(url, session)
            results.append(result)
            ads = ", ".join(result["ads_found"]) or "None"
            safe = "SAFE" if result["brand_safety"] else "UNSAFE"
            print(f"  [{i+1}/{len(urls)}] {url}: {ads} [{safe}]")
        except Exception as e:
            results.append({
                "url": url,
                "error": str(e),
                "timestamp": datetime.utcnow().isoformat(),
            })
            print(f"  [{i+1}/{len(urls)}] {url}: ERROR - {e}")

        time.sleep(2)

    with open(output_file, "w") as f:
        json.dump(results, f, indent=2)

    # Summary
    total = len(results)
    safe = sum(1 for r in results if r.get("brand_safety"))
    captchas = sum(1 for r in results if r.get("captcha_solved"))
    errors = sum(1 for r in results if "error" in r)

    print(f"\n  Total: {total} | Safe: {safe} | CAPTCHAs solved: {captchas} | Errors: {errors}")

    return results


# Publisher URLs to verify
publisher_urls = [
    "https://publisher1.com/article/tech-news",
    "https://publisher2.com/sports/latest",
    "https://publisher3.com/finance/markets",
]

run_verification(publisher_urls)
Функция run_verification прогоняет весь список издателей, пишет JSON-отчёт и в конце печатает сводку: сколько страниц проверено, сколько CAPTCHA решено и сколько запросов упало с ошибкой.
Издатели за Cloudflare Turnstile
Премиальные издатели чаще всего стоят за Cloudflare, и здесь стоит различать два случая: обычный виджет Turnstile на странице и полная проверка через код ответа 403. Первый решается напрямую по sitekey, второй требует передать прокси прямо в запрос на решение — иначе полученный токен не совпадёт с IP-адресом, с которого пойдёт следующий запрос:
def handle_cloudflare(url, session):
    """Handle Cloudflare-protected publisher pages."""
    resp = session.get(url)

    if "cf-turnstile" in resp.text:
        match = re.search(r'data-sitekey=["\']([^"\']+)', resp.text)
        if match:
            token = solve_captcha("turnstile", {
                "sitekey": match.group(1),
                "pageurl": url,
            })
            return session.post(url, data={
                "cf-turnstile-response": token,
            })

    if resp.status_code == 403 and "cf-browser-verification" in resp.text:
        data = solve_captcha("turnstile", {
            "pageurl": url,
            "proxy": "user:pass@proxy:port",
            "proxytype": "HTTP",
        })
        # Parse qa_validation_cookie and use same proxy
        return data

    return resp
Если издатель отдаёт нужную вёрстку при обычном GET-запросе, headless-браузер не нужен вообще — requests и решение CAPTCHA закрывают задачу. Браузер в headless-режиме имеет смысл подключать только там, где контент рендерится через JS, например в видеоплеере.
Пример: гео-аудит для рынков России и Казахстана
Агентство, которое ведёт медиапланирование для клиентов в России и Казахстане, обычно проверяет размещение отдельно по каждому гео: одна и та же кампания показывает разный креатив в зависимости от региона показа, и отчёт должен это подтверждать. Команда прогоняет список издателей через прокси нужной страны и сверяет, что объявление соответствует таргетингу, а не просто «где-то показалось».
При объёме 300–400 страниц в час тарифа STANDARD ($30/мес, 15 потоков) обычно достаточно. Агентствам, которые проверяют несколько кампаний параллельно и упираются в лимит одновременных запросов, чаще подходит ADVANCE ($90/мес, 50 потоков). Прокси в этой схеме нужен не для того, чтобы спрятаться от защиты издателя, а для того, чтобы гео-контекст решения CAPTCHA совпадал с тем регионом, для которого проверяется кампания — иначе в отчёте окажется верное объявление, показанное не в том месте.
Частые вопросы о проверке рекламы
Сколько потоков CaptchaAI нужно для аудита рекламы?
Ориентируйтесь на число одновременных проверок, а не на страницы в сутки. Для 5–10 параллельных запросов хватает BASIC ($15/мес, 5 потоков) или STANDARD ($30/мес, 15 потоков). Если аудит идёт сразу по нескольким кампаниям и упирается в лимит потоков, переходите на ADVANCE ($90/мес, 50 потоков).
Подходит ли этот подход для проверки видеорекламы?
Скрипт из этой статьи закрывает медийную и нативную рекламу. Видеоразмещения обычно нужно рендерить в браузере — Selenium или Playwright — потому что видеоплеер загружается через JS, и одного парсинга HTML недостаточно.
Как проверять рекламу в разных регионах, не собирая лишние CAPTCHA?
Используйте прокси из целевой гео-зоны и передавайте параметр proxy в запрос на решение CAPTCHA — тогда решение будет привязано к тому же IP-адресу, с которого пойдёт следующий запрос, и гео совпадёт с таргетингом кампании.
Что делать, если проверка безопасности бренда даёт ложные срабатывания?
Список ключевых слов в примере — стартовая точка, а не готовый классификатор. На практике его дополняют стоп-словами под нишу клиента и исключениями для страниц, где слово встречается в нейтральном контексте — например, новостная статья про регулирование азартных игр. Ложное срабатывание — повод расширить список условий, а не отключать проверку целиком. Отдельно стоит логировать, какие именно страницы попали под флаг «UNSAFE», чтобы разбор правил не превращался в угадывание.
Обязательно ли использовать headless-браузер вместе с CaptchaAI?
Нет, если издатель отдаёт нужные данные в HTML уже при обычном GET-запросе — тогда достаточно requests и решения CAPTCHA. Headless-браузер нужен там, где контент рендерится через JS: видеореклама, тяжёлые SPA-страницы издателя, отложенная загрузка баннеров. Добавление браузера ощутимо увеличивает время проверки одной страницы, поэтому включайте его только для тех издателей, где без этого не обойтись.
Что читать дальше
- Парсинг защищённых веб-сайтов
- Рекомендации по настройке прокси-сервера
- Проблемы с CAPTCHA в headless-браузере