Скрипт падает на шаге с CAPTCHA, и непонятно — это баг или ожидаемое поведение? В собственных или явно авторизованных workflow (QA, staging, внутренняя автоматизация) корректная обработка CAPTCHA сводится к трём вещам: предсказуемый таймаут, идемпотентные ретраи и логи, по которым видно, где именно всё сломалось. Ниже — рабочая схема на API CaptchaAI и код, который можно вставить в пайплайн уже сегодня.
Безопасный контур применения. Материал касается только собственных или явно авторизованных QA-, staging- и production-сред: диагностика, тестирование и наблюдаемость вашей собственной интеграции с CAPTCHA — не сторонние сайты и не несанкционированные сценарии.
Когда CAPTCHA мешает собственной автоматизации
Если staging специально настроен «один в один» с production, там же остаётся и CAPTCHA — reCAPTCHA v2/v3, Cloudflare Turnstile или GeeTest v3 на форме входа. Автотесты и внутренние скрипты мониторинга упираются в неё точно так же, как обычный пользователь, только должны проходить её предсказуемо и без участия человека. У команд, которые деплоят инфраструктуру в европейские регионы или работают через нестабильные мобильные сети, добавляется ещё один источник шума: сетевые задержки легко спутать с реальным сбоем решения CAPTCHA, если таймаут выставлен слишком коротким.
Схема обработки: от sitekey до pass/fail
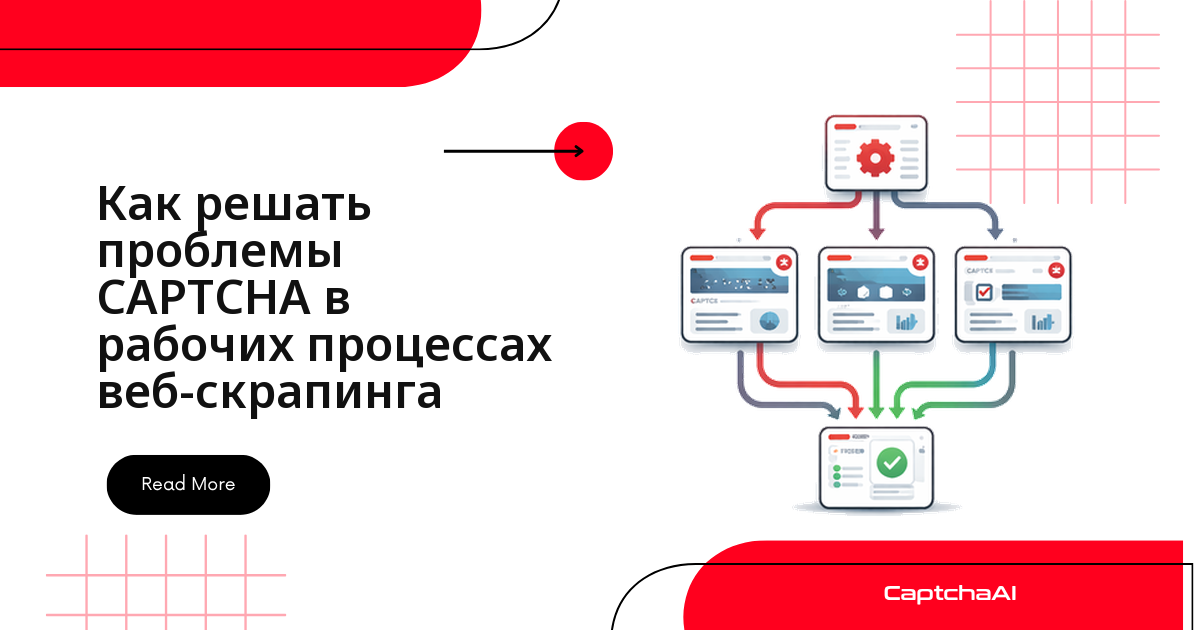
- Определите тип CAPTCHA и sitekey на своей странице.
- Запросите токен через API CaptchaAI.
- Передайте токен на собственный backend.
- Дождитесь ответа валидации.
- Зафиксируйте pass/fail в журнале прогона.
Минимальный солвер на Python
Рабочий пример: отправка задачи и опрос результата.
import os, requests, time

API_KEY = os.environ['CAPTCHAAI_KEY']

def solve(sitekey: str, pageurl: str) -> str:
    r = requests.post('https://ocr.captchaai.com/in.php', data={
        'key': API_KEY, 'method': 'userrecaptcha',
        'googlekey': sitekey, 'pageurl': pageurl, 'json': 1,
    }).json()
    tid = r['request']
    for _ in range(40):
        time.sleep(3)
        res = requests.get('https://ocr.captchaai.com/res.php', params={
            'key': API_KEY, 'action': 'get', 'id': tid, 'json': 1,
        }).json()
        if res['status'] == 1:
            return res['request']
    raise TimeoutError(tid)
Идемпотентность и повторные попытки
Присваивайте свой идемпотентный ключ каждой логической операции — конкретному прогону или шагу CI. Тогда повторную попытку можно запускать безопасно: не нужно запрашивать у CaptchaAI новый токен на каждый ретрай и нет риска задвоить операцию на своём backend.
Что обычно кладут в такой ключ:
- ID прогона CI (
run_id) плюс имя шага — этого достаточно для большинства пайплайнов. - Порядковый номер попытки, если один шаг может ретраиться несколько раз подряд.
- Идентификатор окружения (
staging,qa), если один и тот же шаг гоняется параллельно в разных средах.
Логи и метрики: как поймать регрессию между релизами
Структурированные логи — быстрый по нашей внутренней выборке способ увидеть, что поведение CAPTCHA изменилось между релизами, и найти регрессию в собственных формах раньше, чем это заметят пользователи:
import json, time, logging

log = logging.getLogger('captcha-qa')

def record(event: str, **fields) -> None:
    payload = {'ts': time.time(), 'event': event, **fields}
    log.info(json.dumps(payload, ensure_ascii=False))
Минимальный набор полей для каждой попытки: slug, captcha_type, task_id, wait_seconds, verify_status, env. Этого достаточно, чтобы построить дашборд медианы, P90 и P99 по типу CAPTCHA и по среде.
Сколько потоков нужно для параллельных прогонов
CaptchaAI тарифицирует по количеству одновременных потоков, а не по числу решённых CAPTCHA: в рамках плана можно прогонять сколько угодно задач, лишь бы число параллельных запросов не превышало лимит потоков. Для пяти параллельных QA-раннеров хватает BASIC ($15/мес, 5 потоков). Если CI одновременно поднимает 50 параллельных джобов, которые могут упереться в CAPTCHA, стоит смотреть на ADVANCE ($90/мес, 50 потоков) — иначе лишние прогоны встанут в очередь и увеличат общее время пайплайна.
Типичные проблемы и решения
| Симптом | Что сделать |
|---|---|
| Бесконечный pending | Проверьте баланс ключа |
| Токен невалиден | Сверьте pageurl и sitekey |
| Высокая доля ошибок | Снизьте параллелизм |
| 429 от backend | Включите экспоненциальные ретраи |
Чек-лист перед выкладкой в CI
- Запросы уходят только на собственные или явно авторизованные endpoints.
- Тестовые аккаунты, события и платежи помечены как фиктивные.
- Токен CAPTCHA проверяется на собственном backend, а не принимается со стороны клиента без проверки.
- В логах есть
task_id, тип CAPTCHA, время ожидания и pass/fail. - Скрипт возвращает корректный exit code, чтобы CI мог принять решение по прогону.
- В логах тестовых прогонов нет лишних персональных данных (реальных email, телефонов) — это касается даже сценариев с фиктивными аккаунтами: минимальный уровень внимания к обработке персональных данных задают и 152-ФЗ, и GDPR-подобные требования для кросс-граничных команд.
FAQ
Можно ли применять эту схему к сторонним сайтам?
Нет. Все сценарии в этом руководстве рассчитаны только на собственные или явно авторизованные среды. Для чужого ресурса нужно письменное разрешение владельца — без него не запускайте автоматизацию против чужой CAPTCHA.
Что делать, если CaptchaAI вернул ошибку во время прогона?
Залогируйте task_id, тип CAPTCHA и текст ошибки, повторите запрос с экспоненциальной задержкой и следите за долей ошибок на дашборде. Если доля ошибок стабильно растёт — это повод перепроверить sitekey и адрес страницы, а не просто увеличивать число ретраев.
Сколько потоков нужно для параллельных QA-прогонов?
Считайте от числа раннеров, которые реально могут одновременно ждать решения CAPTCHA, а не от общего числа тестов в наборе. BASIC (5 потоков) хватает для небольшого CI, ADVANCE (50 потоков) — для крупных параллельных прогонов; подробнее — в разделе про тарификацию выше.
Как сравнивать результаты между релизами?
Храните логи в едином формате и стройте отчёт по медиане, P90 и P99 на сопоставимом наборе сценариев. Сравнивать имеет смысл только одинаковые прогоны в одной и той же среде — иначе разница в задержке сети скроет реальную регрессию.
Нужно ли отдельно защищать логи с тестовыми данными?
Да, даже если аккаунты и платежи фиктивные. Не сохраняйте в логах реальные email, телефоны или другие персональные данные без необходимости — это общее правило гигиены логирования, а не специфика CaptchaAI.
Дальше по теме
- Быстрый старт CaptchaAI
- QA-тестирование CAPTCHA в авторизованных средах
- Тестирование API CAPTCHA на собственных формах
- Почему браузерный тест падает, а API проходит
- reCAPTCHA v2 через API
- Cloudflare Turnstile через API
- GeeTest v3 через API
Готовы обрабатывать CAPTCHA в собственных пайплайнах? Подключите CaptchaAI.